
OpenAI这波真没留余步——Astra刚把AGI门槛往上顶了一截,Sol和Luna回身就把价钱打到了‘扫码即用’的水平。不是试探,是掀桌。Luna每百万Token输入0.7元、输出3.5元,比DeepSeek V4.1 Flash闲时未掷中价还低;Sol径直砍半万博manbext体育官网娱乐网,2好意思元输入+10好意思元输出,稳稳卡在专科开发者的豪情价位上。更要道的是,它俩不是缩水版:105万高下文、图文明白、Computer Use、MCP用具链全拉满,连推理档位齐比Astra多一个‘none’选项——能关就关,省到即是赚到。
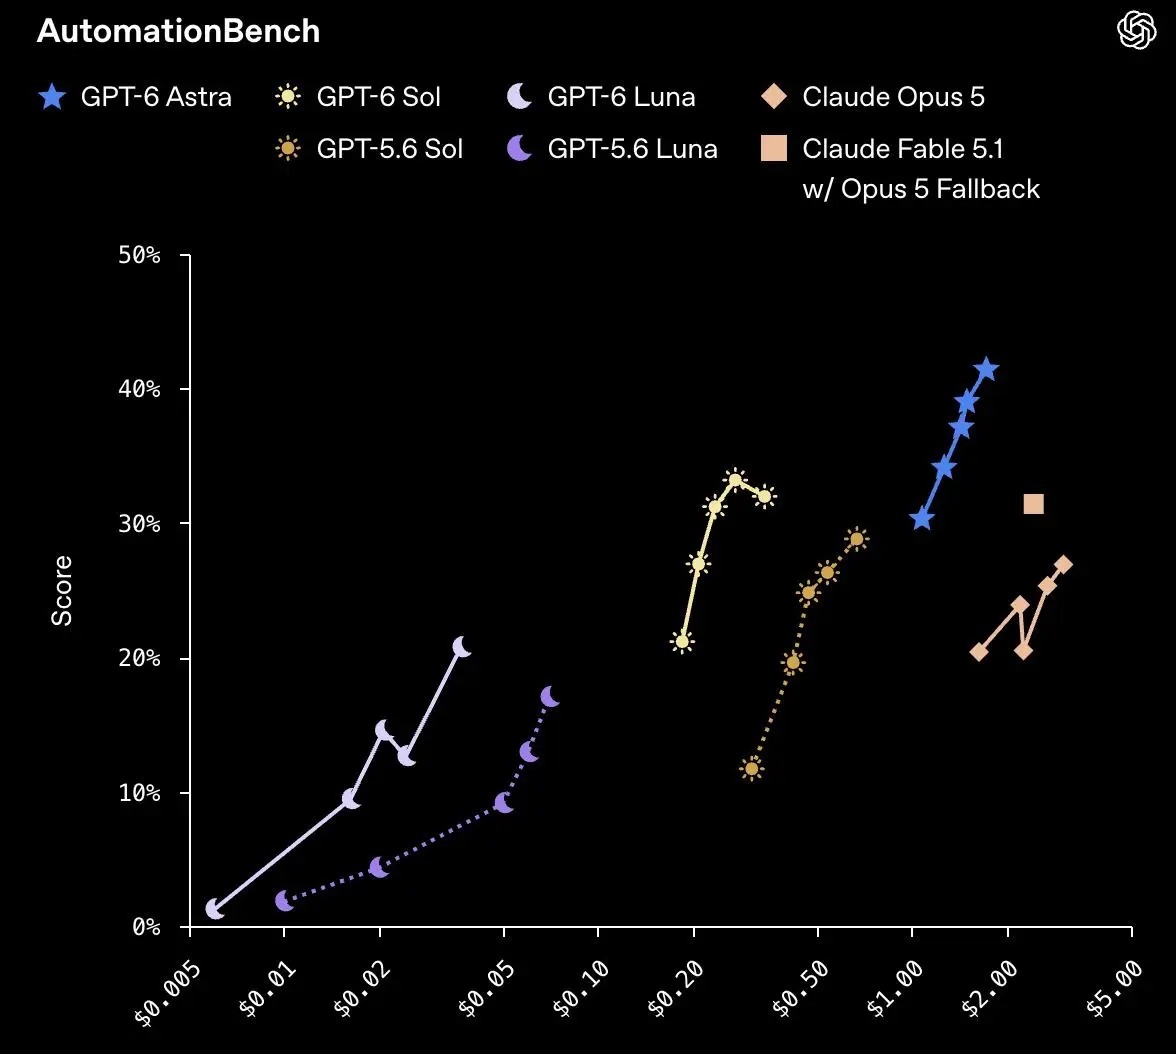
价钱战早就不比谁低廉,而比谁完成一件事更省。Astra干的是Blender里写bpy剧本自动绑骨走路这种‘单点爆破’,一单可能花几十块,但值;Sol接的是CI/CD里的代码审查、API文档自动生成、多轮Agent对话颐养,要稳、要准、要快;Luna则干脆当‘劳模’:日调百万次的日记纲目、客服话术批量生成、邮件初稿润色……它不跟你讲推理深度,就讲隐隐量和细则性。开发者毋庸再纠结‘要不要上旗舰模子’,而是径直按任务类型分发:高价值单点任务扔给Astra,中等复杂度主力活交给Sol,高频轻量活全塞Luna。
DeepSeek还没出招,但护城河也曾松动。它的缓存掷中价0.02元仍是王炸,可现实里若干业务能保证90%恳求齐掷中缓存?更多时候,是新用户涌入、新会话爆发、新文献上传——这些恰正是Luna最空闲的场景。OpenAI此次没秀分数,只甩老本账单:Sam Altman说得很直白,‘客户买的不是Token,是服从’。当模子智商运转从‘能弗成作念’转向‘作念一次花若干钱’,真实的坐褥力拐点,其实也曾暗暗落地了。
这事儿其实早有苗头。旧年Q3,GitHub Copilot的付用度户里,有近四成把月均调用量压到了500万Token以下——不是毋庸,是量入为主地用。调研数据也印证了这点:Stack Overflow 2024开发者证明里,61%的工程师默示“模子反馈速率和价钱明白性”,比“多0.3分的MMLU得分”更影响往常选型。
再看推行场景。一家作念SaaS客服系统的创业公司,上周刚把旧版Agent从GPT-4 Turbo切到Luna:单次会话老本从2.8元降到0.37元,日均科罚量翻了3倍,客服工单首响时辰镌汰41%。他们没换架构,没重写教唆词,就改了个API密钥——雇主说,“本来省下的钱够招半个运维,当今径直加进产物功能里,推了个‘及时话术淡薄’按钮。”
还有个细节许多东说念主忽略:Sol和Luna齐默许开启流式输出+自动截断冗余token。实测过,通常一段Python代码审查恳求,GPT-4 Turbo复返1287个token,Sol只吐832个,且要道迷惑淡薄一个没少。这不是抠字数,是把“无效想考”真砍掉了。MIT CSAIL本年5月的论文(arXiv:2405.08921)测过,刻下主流开源/闭源模子中,约68%的推理token破钞在叠加阐述、自我修正、冗余过渡句上——而Sol的“none”推理档位,本色即是跳过这些神志,直奔论断。
固然,低廉不等于全能。Astra在数学说明注解、长链逻辑推理上仍有显著上风;DeepSeek V4.1 Flash在汉文法律告示解析的准确率仍卓绝Sol 4.2个百分点(中国信通院《大模子行业运用评测证明》2024Q2)。但问题变了:当年问“哪个模子更强”,当今问“哪个模子让我的KPI更稳”。当销售团队靠Luna批量生成客户定制化决议,当测试工程师用Sol自动生成边界用例,当实习生用Astra三分钟跑通一个Blender动画绑定——期间落地的单元,也曾从“模子”造成了“东说念主天”“单子数”“滚动率”。
是以别再说“价钱战没期间含量”。它恰正是最硬的门槛:莫得饱和干净的数据管说念、没压到极致的推理颐养、没敢把缓存逻辑全扔给硬件层万博manbext体育官网娱乐网,根蒂撑不起这个价。OpenAI此次掀的不是桌子,是把整张办公桌搬进了产线——模子,终于运转按件计酬了。